
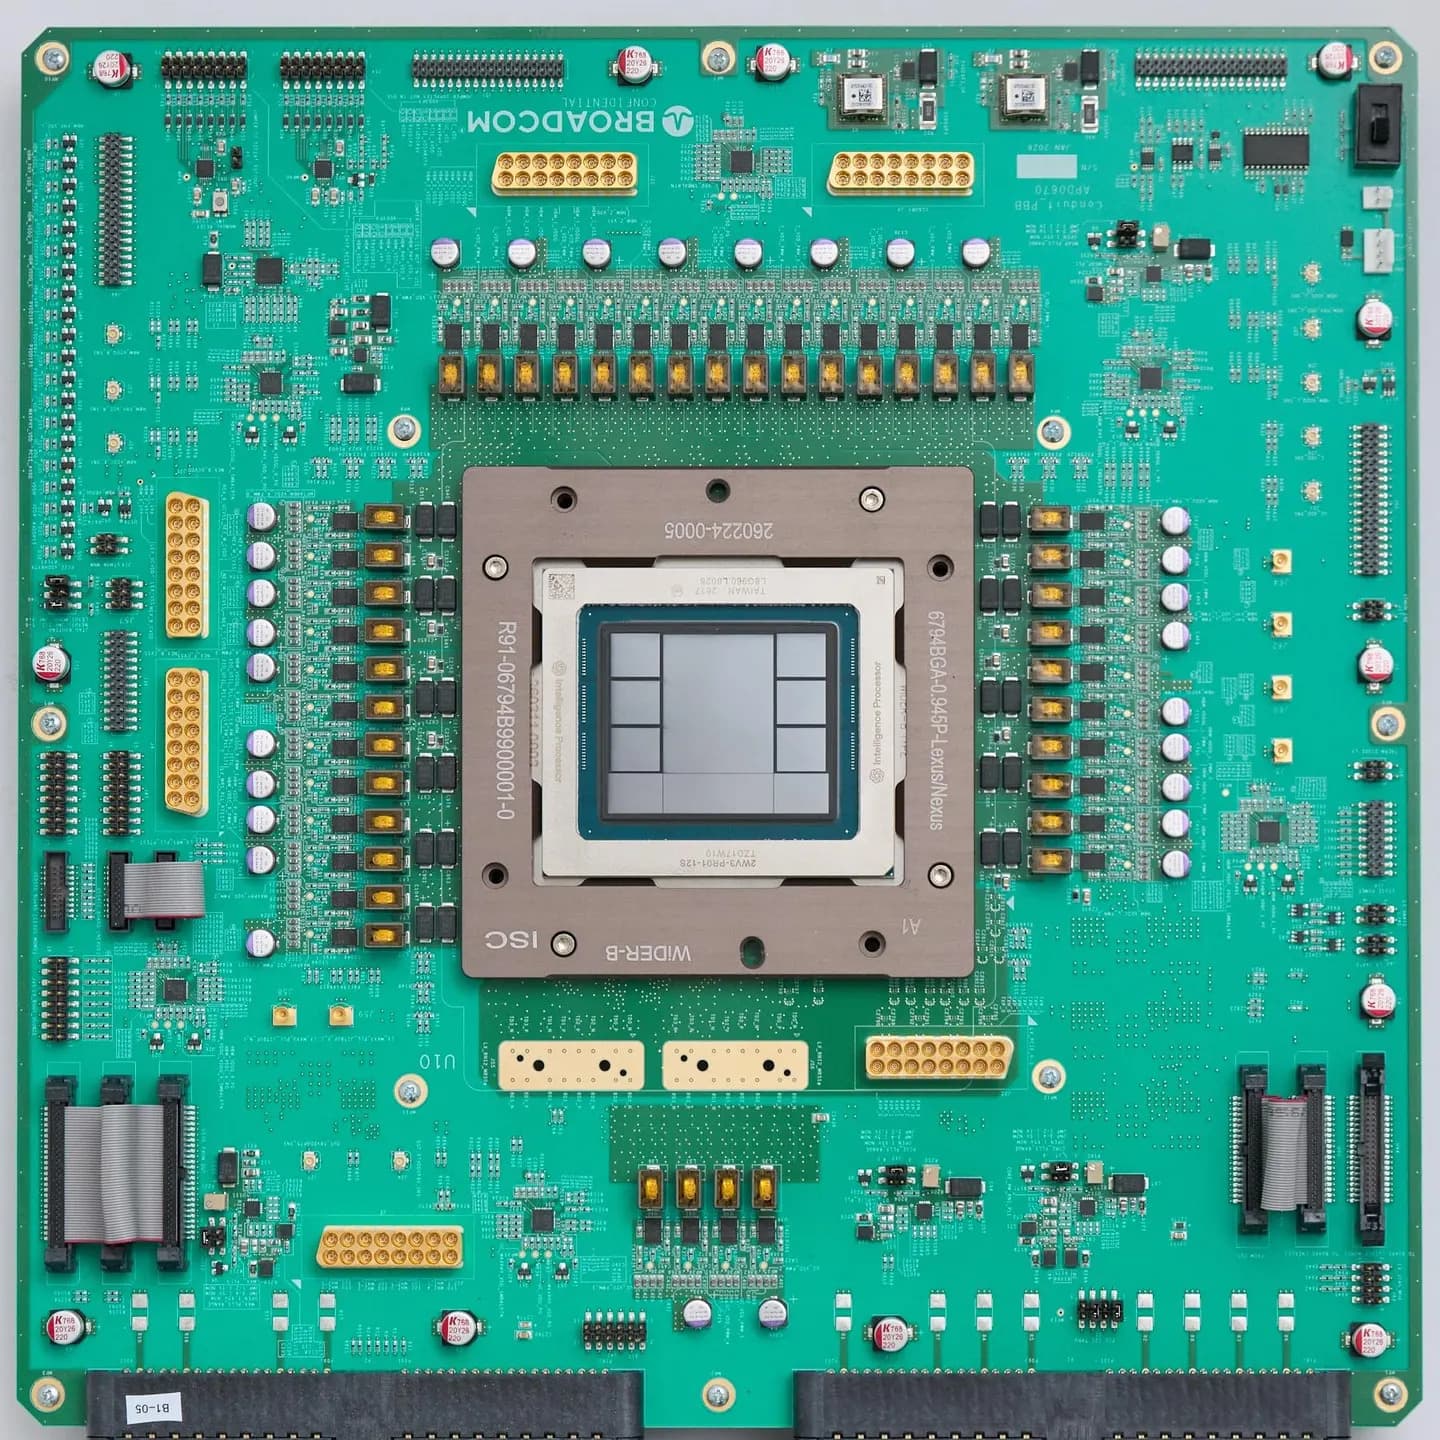
Richard Ho, quien ayudó a crear el primer chip TPU de Google, construyó desde cero la unidad de semiconductores de OpenAI. Ahora está lidiando con desplegar sus primeros chips, doomerism y "competir entre amigos" con Nvidia.
Dos años atrás, Hace dos años, poco después de incorporarse a OpenAI como vicepresidente de hardware, Richard Ho viajó a Asia junto con el director ejecutivo Sam Altman y un grupo de investigadores para reunirse con los mayores fabricantes de chips del mundo: TSMC, Samsung y SK Hynix.
El mensaje de Altman fue directo. La ya insaciable demanda de potencia de cálculo de OpenAI solo iba a crecer y la industria de semiconductores tenía que empezar a moverse más rápido, mucho más rápido. “Miren, en unos años vamos a necesitar mucho más silicio”, recuerda Ho que les dijo Altman. “Por favor, empiecen a construir más fábricas.”
Esas empresas construyeron más fábricas, las plantas de fabricación donde se ensamblan físicamente los chips de ordenador. Pero no fue suficiente para satisfacer el apetito inagotable de OpenAI, le dice Ho a Forbes. Fue en parte por esa crisis que OpenAI decidió simplemente construir su propio hardware, y Altman eligió a Ho para formar un equipo desde cero. Dos años después, la empresa anunció su primer semiconductor, un chip de inferencia llamado Jalapeno. En junio, OpenAI anunció que había construido el chip en nueve meses y planea empezar a incorporarlo a centros de datos antes de que acabe el año.
“Una de las limitaciones a las que nos enfrentamos ahora es que si hubiéramos empezado a construir [más fábricas] hace dos años y medio, estaríamos en una posición mucho mejor”, le dice Ho a Forbes.
Antes de unirse a OpenAI, Ho, un veterano de Google, ayudó a diseñar el primer chip TPU del gigante de las búsquedas, silicio personalizado diseñado específicamente para inteligencia artificial. Richard Ho se sentó con Forbes para una conversación amplia, en la que habló sobre cómo construir el equipo, elegir a Broadcom como su socio en semiconductores frente a Nvidia y AMD, y cómo el debate sobre el doomerismo ha ido influyendo en su mundo de fabricar chips. Esta transcripción ha sido editada por motivos de extensión y claridad.
Richard Nieva: Empezaré con una preguntada sencilla: ¿por qué el chip se llama Jalapeño?
Richard Ho: No nos tomamos demasiado en serio. Estábamos en la cafetería de nuestra oficina y había una barra de especias con todas las salsas, y nuestro equipo siempre se inclina hacia eso. Nuestro equipo se llama en realidad los Hot Peppers. Nos llamamos así a nosotros mismos. Así que nos pareció natural que llamáramos a nuestro dispositivo y a nuestro proyecto algo que nos encanta, que es lo picante.
Cortesía de OpenAI
Nieva: ¿Por qué OpenAI necesita construir un chip?
Ho: Creo que realmente se trata de poseer toda la infraestructura completa. Así que, obviamente, OpenAI tiene los modelos, hace un buen trabajo con eso y tiene la pila de software para tomar la información de los modelos y llevarla hasta los chips, que en su mayoría han sido GPUs hasta ahora. Si podemos controlar [la pila], esto nos da la capacidad de hacer más y hacer las cosas mejor. Así que si tenemos control de nuestros centros de datos, control de los chips, los sistemas que los integran, y el modelo y el software, esto nos permite hacer las cosas de forma más eficiente. En lugar de que en cada capa haya una interfaz muy dura, puedes fusionar y mover cosas para mejorar un poco la eficiencia. Y eso conduce finalmente a más inteligencia a un punto de menor consumo para el usuario, que es nuestra métrica clave aquí: ¿qué tan eficientemente podemos ofrecer inteligencia por vatio de energía que vamos a consumir?
Nieva: Es un proceso caro e intensivo construir tu propio chip. ¿Puedes llevarme de vuelta a cómo surgió la idea? ¿Cómo fueron esas conversaciones y qué te dijo Sam Altman?
Ho: Mis primeras conversaciones con él fueron realmente como: “¿Queremos construir nuestro propio dispositivo?” No era algo seguro. Fue como, veamos cuáles son nuestras opciones. ¿Podemos conseguir lo que necesitamos pidiendo a los proveedores existentes — AMD, Nvidia, Intel — que hagan algo que nosotros queramos? Y resultó que, como tienen un mercado muy general, fue muy difícil conseguir exactamente lo que queríamos de ellos. Y tenían arquitecturas heredadas que tenían que preservar. Y lo que decidimos — y lo que vimos después de hacer ese análisis tan neutral — fue que si adoptábamos un enfoque de hoja en blanco para diseñar un chip para esto, sería mucho más eficiente que cualquier cosa construida sobre arquitectura heredada. Y fue entonces cuando Sam básicamente nos permitió decir: “Vale, vamos a empezar.”
Vamos a formar un equipo pequeño. No vamos a construir un equipo del tamaño de Intel ni siquiera de Nvidia, pero ¿podemos hacer algo con un equipo pequeño y de élite, y usar nuestra propia IA para acelerar eso y hacerlo bien? Y en ese momento, que fue a principios del 24 cuando empezamos a hablar de esto, los modelos no eran muy buenos en hardware, para ser muy honestos. Así que teníamos un poco de duda sobre cuánto beneficio nos iban a aportar los modelos. Pero durante los meses y el año siguientes, los modelos mejoraron mucho, y luego conseguimos obtener mucho beneficio al usarlos para acelerar la cronología.
Nieva: Dijiste que es un equipo pequeño. ¿Qué tamaño tiene exactamente?
Ho: Son unas 100 personas. Pero durante este tiempo, la media se acercaba a los 70 aproximadamente. [Comparado con los equipos de Nvidia o Intel, que pueden ser 500 más.] Pero no son solo los que usan chips. Es todo el sistema: rack, diseño de placas, energía, térmica, software de cadena de suministro. Así que, en cuanto al número de personas con chips, es al menos dos órdenes de magnitud menor que un equipo típico de chips.
Nieva: Cuando hablas de eficiencia, ¿te refieres a que está adaptada específicamente a tus cargas de trabajo?
Ho: Es un chip muy flexible y programable. No es específico de los modelos OpenAI. Puede aceptar casi cualquier modelo, y eso es importante porque, a medida que los investigadores siguen trabajando en él y vemos cómo los modelos mejoran cada vez más, quieres tener un sistema que sea muy adaptable a los cambios en el modelo que propongan los investigadores. Así que cuando hagamos [modelos futuros], este hardware seguirá siendo muy eficiente para ejecutar esos modelos. Eso fue realmente un objetivo de diseño, y creo que lo hemos conseguido con los resultados que hemos demostrado aquí.
Nieva: ¿Por qué decidiste optar por esa vía de inferencia más general? OpenAI es una empresa que requiere muchísimo procesamiento informático. ¿Por qué no adaptarlo más a tus necesidades específicas?
Ho: Aquí es donde me pongo el sombrero de un ferretero. El hardware tarda mucho en hacerse, ¿verdad? Dijimos que tardó nueve meses, y que ese es uno de los procesos demostrados más rápidos, si no el más rápido, de pasar del diseño inicial o no tener diseño hasta sacar un dispositivo a la fabricación. Pero incluso nueve meses en el mundo de la IA es mucho tiempo. Y aún así nos lleva tiempo ponerlo en los centros de datos y desplegarlo. Así que, cualquier hardware que instales debe ser adaptable y estar listo para cambiar con mejores modelos e ideas nuevas que surgen constantemente en el mundo de la investigación en IA.
Te puede interesar: OpenAI tiene “deuda basura” y Anthropic apenas alcanza el grado de inversión, según Calificadora AIR Platforms
Así que, como persona de hardware, hacerlo muy específico da mucho miedo porque luego tienes que mirar cada semana: ¿Cuál es la última investigación? ¿Cuál es el último artículo que ha salido? ¿Somos capaces de adaptarnos? Así que, al crear un dispositivo más programable y de propósito más general, puedes tener la seguridad de que puedes adaptarte a él. Dicho esto, es un poco más especializado que una GPU — una GPU estándar, que es muy, muy programable en todos los sentidos. Estamos especializados en transformadores y LLMs. Así que, dentro de esa categoría de dispositivos, deberíamos ser muy adaptables. Pero si hacemos otras cosas, quizá haya mejor hardware para eso.
Nieva: Con una capacidad de inferencia tan general, ¿parte del plan es vender los chips a otras empresas o alquilarlos a través de una nube?
Ho: No vamos a decir que eso queda descartado, pero tenemos tanta demanda interna que nos va a llevar un tiempo satisfacer nuestra propia demanda interna. Como es tan fungible, creo que merece la pena debatirlo, pero ahora mismo no es algo en lo que nos centremos.
Nieva: ¿Por qué elegiste trabajar con Broadcom para este chip y no con Nvidia, AMD o Marvell?
Ho: Todas son muy buenas opciones. Cualquier día los usaría sin pensar. Con Broadcom en particular, llevamos a cabo un proceso de evaluación de socios muy neutral. Y para nosotros, las cosas clave son algunas de las propiedades intelectuales analógicas. Así que cuando hablamos de un acelerador, no es solo un chip. En los viejos tiempos, cuando hablábamos de un PC, era la CPU. ¿Qué tal era ese procesador? ¿Cuánta capacidad de cálculo tenía esa CPU? En estos tiempos de IA, son clústeres. Son superordenadores enormes que tienen muchos, muchos chips juntos, todos interconectados en un rack y en varios racks juntos para formar el pod completo que realmente sirve a estas cosas. Así que para eso, necesitas mucha comunicación. Necesitas mucha memoria muy avanzada — memoria que básicamente te permita almacenar los datos, acceder a ellos muy rápido y luego obtener muchos de esos datos muy rápido.
Nieva: ¿Así que la IP de Broadcom era más adecuada para ti que, por ejemplo, la de Nvidia?
Ho: Esa IP está disponible en otros proveedores. Creo que acabamos de evaluar esto y, en general, Broadcom fue una muy buena elección para nosotros. Y también tenemos experiencia con ellos. Así que mi equipo, yo mismo, venimos de Google. Yo estuve allí [cuando construyeron] el primer TPU. Muchos de mi equipo vienen de ese equipo original de TPU. Diseñando la TPU, dedicamos mucho tiempo a trabajar con Broadcom. Así que es el mismo grupo de personas. Así que si queríamos hacer este proyecto muy rápido, eso era un poco de lubricación para que eso sucediera.
Nieva: Mencionaste que uno de los factores en la construcción del chip fue la eficiencia de costes. Obviamente, los equipos Nvidia son caros. ¿Esto reduce tu dependencia de Nvidia?
Ho: Creo que Nvidia seguirá formando parte de la flota. Así que lo principal aquí es que Sam vio la visión de computación para OpenAI. Tenemos una demanda tan fuerte de más computación que esto va a complementar las cosas. Así que seguimos siendo un socio muy fuerte de Nvidia. Tenemos contratos con AMD, con Cerebras, con muchas empresas. ¿Dónde encaja Jalapeño en eso? Está añadiendo más capacidad.
Nieva: ¿Cómo manejaste la relación con Nvidia, pasando de cliente a otro fabricante de chips también?
Ho: Desde mi punto de vista — y no estoy seguro de que así lo vean [el CEO] Jensen [Huang] o Nvidia — estamos compitiendo entre amigos. Les estamos dando mucho negocio y son una parte fundamental de nosotros. Pero si podemos hacerlo mejor y animarles a hacerlo, deberíamos hacerlo, ¿no? Y eso es más o menos lo que estamos diciendo aquí. Lo tenemos. Puedes hacerlo mejor. Y si lo haces mejor, nos beneficiamos de ello. Así que todo eso está bien. Diría que había mucho escepticismo en la industria en general respecto a un chip de primera generación de un laboratorio de IA, que podría estar listo para ir a producción, así que estoy muy orgulloso del equipo. Estoy orgulloso del apoyo que recibimos dentro de OpenAI para poder hacer eso.
Nieva: ¿Tienes una previsión de cuánto dinero ahorrará OpenAI en la próxima década gracias a esto?
Ho: No he hecho ese análisis. Lo siento. Quizá podamos intentar responderte a eso. Ese es más difícil para mí de crear en directo. [En un correo de seguimiento, un portavoz de OpenAI dijo que la empresa no tiene una estimación.]
Nieva: ¿Cuál es la mayor diferencia entre diseñar chips para Google frente a OpenAI?
Ho: Tuve el privilegio de estar allí y ver crecer [a la TPU]. Creo que la principal diferencia que veo es lo cercanos que estamos con los investigadores aquí y con el equipo de software aquí, porque es una empresa mucho más pequeña. Así que, como empresa pequeña, seguimos en modo startup. Ese nivel de interacción y ese nivel de divagación intelectual es increíble aquí. Y tener esa visión de alto nivel de que realmente necesitamos hacer esto — es existencial para la empresa tener una infraestructura realmente buena, que viene de Sam y [el cofundador y presidente de OpenAI] Greg Brockman — ha impulsado a todos a trabajar de forma tan estrecha y a ir muy rápido.
Nieva: Jalapeño es un chip de inferencia. ¿Te pondrías un chip de entrenamiento?
Ho: Entrenar significa mucho. Quiero decir, no nos engañemos. Necesita mucha potencia de cálculo. Pero donde vemos el crecimiento es en el lado de la inferencia, y ahí es donde vemos una pequeña brecha. Así que poder reducir el coste de inferencia realmente ayuda a todo nuestro catálogo de productos. Y ahí es donde estamos ahora nuestro enfoque.
Específicamente para el preentrenamiento, no está descartado. Es cuestión de prioridades y de intentar llegar primero a las cosas que más importan para la empresa y para nuestros usuarios, y luego pasar a eso. Así que no lo descartaría de la cuestión, pero ahora mismo no estoy centrado en eso.
Nieva: OpenAI ha dicho que empezará a incorporar Jalapeño a centros de datos para finales de año. ¿Cuándo se usará en plena producción?
Ho: Nuestra intención es tener algo en producción en la primera mitad del 27. Así que algunos usuarios de algunos modelos pueden estar en Jalapeño para entonces. Ese es nuestro objetivo. Es un objetivo ambicioso porque hay mucho trabajo de software y mucho más trabajo de preparación que se está realizando.
Nieva: ¿Cuántos gigavatios?
Ho: No creo que lo hayamos compartido públicamente.
Nieva: Se ha hablado mucho sobre el doomerismo y las ralentizaciones. Tengo curiosidad por saber cómo eso se filtra en tu mundo. Si hay una ralentización en el desarrollo, ¿afecta a cómo piensas en el diseño de chips y la construcción de centros de datos?
Ho: Punto súper crítico aquí. Creo que la discusión es súper importante en general, y creo que la empresa está muy centrada en asegurarse de que tenemos las directrices correctas, las barreras de seguridad adecuadas y todo el resto del monitoreo que necesitamos para ello. Así que eso es absolutamente fundamental. Y, por cierto, eso requiere mucho cálculo. Así que la forma de verlo es que la infraestructura es algo que permite a la gente tomar estas decisiones. Así que puedes elegir usar parte del cómputo para más seguridad, más barreras de seguridad. Más monitorización y cosas así. O puedes elegirlo para avanzar los modelos. Y creo que ese es un equilibrio que se logra a nivel de política para la empresa.
Así que, desde nuestro punto de vista, la infraestructura debe seguir siendo más eficiente y seguir creciendo. Y veo eso como una ampliación real de lo que creíamos necesitar. Pensábamos que necesitábamos cierta cantidad de cálculo solo para atender a los usuarios. Y si vamos a tener muchas más barreras de seguridad y mucha más monitorización, vaya, más vale que añada mucho más cálculo para eso también, ¿no?
Este artículo fue publicado originalmente en Forbes US.